 Oleh Ilham Musyafa · 23 Oktober 2026
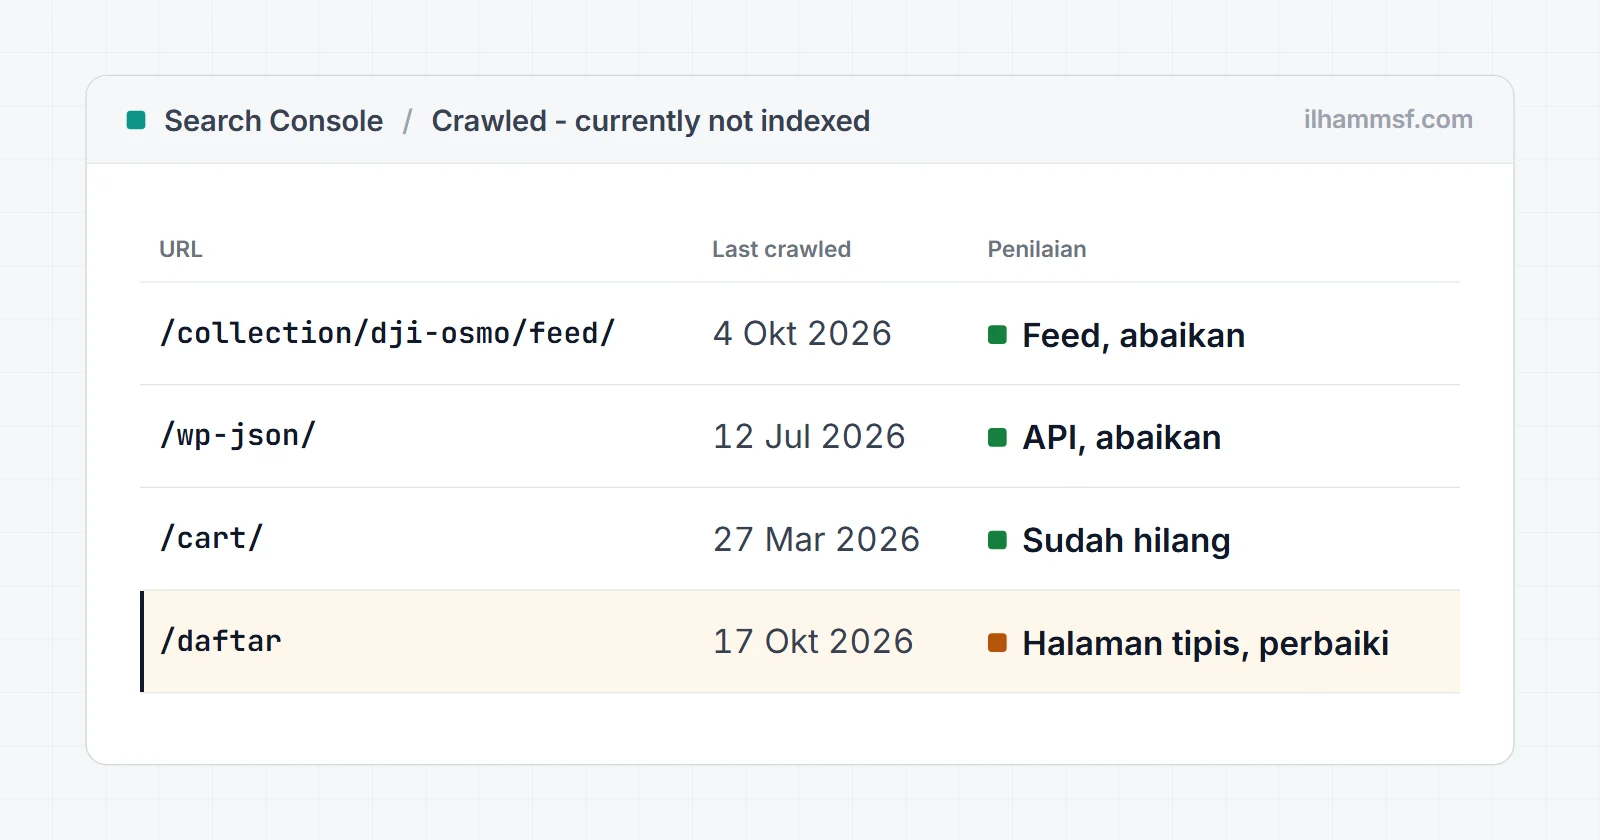
Status Crawled - currently not indexed (Di-crawl - saat ini tidak diindeks) di Google Search Console artinya Google sudah mengambil dan membaca halaman kamu, lalu memutuskan tidak memasukkannya ke indeks untuk sementara. Tidak ada yang memblokir. Ini keputusan Google. Jadi solusinya tidak pernah satu tombol atau satu pengaturan. Pilihannya hanya dua: terima bahwa URL itu memang tidak perlu ada di Google, atau buat halamannya layak diindeks.
Langkah pertama selalu sama, dan paling sering dilewati: lihat dulu URL apa saja yang ada di daftar. Di banyak website, sebagian besar isinya feed, endpoint API, halaman keranjang, dan URL sistem lain yang memang tidak perlu muncul di Google. URL seperti itu tidak perlu diperbaiki.
Apa Arti Crawled - Currently Not Indexed?
Google bekerja bertahap. URL ditemukan, dirayapi (crawl), dirender, lalu diputuskan diindeks atau tidak. Status ini ada di tahap paling akhir. Googlebot boleh masuk, halaman berhasil dimuat, tidak ada noindex, canonical juga tidak mengarah ke halaman lain. Tapi Google tetap memilih tidak mengindeksnya.
Di halaman bantuan laporan Page indexing (Pengindeksan halaman), Google menjelaskan status ini apa adanya: halaman sudah di-crawl tapi tidak diindeks, mungkin diindeks nanti, mungkin juga tidak, dan tidak perlu dikirim ulang untuk di-crawl. Kolom Source (Sumber) di laporan juga menulis Google systems (Sistem Google), bukan Website. Artinya ini keputusan Google, bukan blokir yang kamu pasang.
Status ini sering tertukar dengan Discovered - currently not indexed (Ditemukan - saat ini tidak diindeks). Bedanya penting. "Discovered" berarti Google sudah tahu URL-nya tapi belum merayapinya, jadi masalahnya ada di jadwal crawl. "Crawled" berarti Google sudah membaca halamannya, jadi masalahnya ada di isi halaman dan sinyal di sekitarnya.
Contoh Nyata dari Website Saya Sendiri
Ini laporan untuk tangkaprasa.com, usaha rental kamera yang saya jalankan di Jogja. Ada 5 URL dengan status ini:
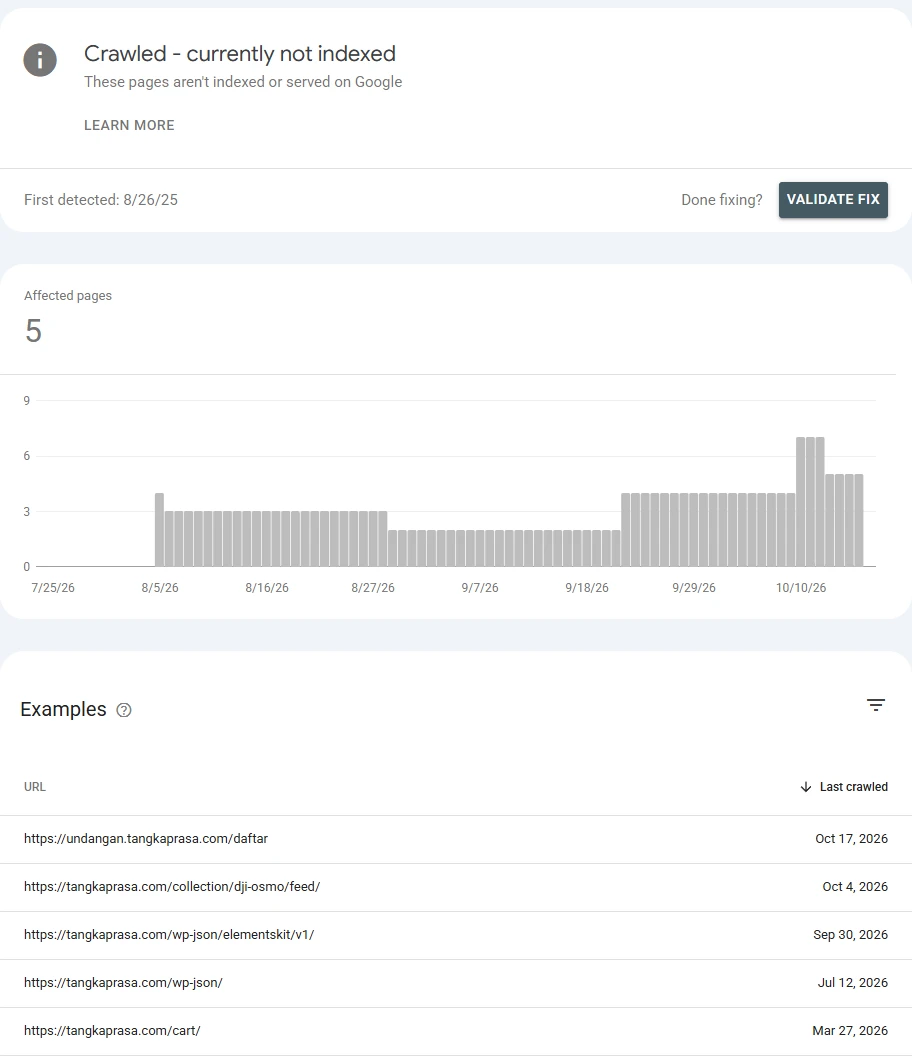
Baca contohnya dulu sebelum memperbaiki apa pun:
/collection/dji-osmo/feed/adalah feed RSS yang dibuat otomatis oleh WordPress untuk tiap halaman arsip. Isinya salinan halaman collection dalam format feed./wp-json/dan/wp-json/elementskit/v1/adalah endpoint REST API WordPress. Isinya data JSON untuk script, bukan halaman untuk dibaca orang./cart/adalah halaman keranjang yang sudah tidak ada. Sekarang hasilnya 404.undangan.tangkaprasa.com/daftaradalah halaman pendaftaran produk lain di subdomain. Hanya URL ini yang mungkin dicari orang.
Jadi 4 dari 5 baris memang URL yang tidak perlu ranking. Google sampai ke kesimpulan yang sama dengan saya. Kalau daftar di website kamu mirip seperti ini, biarkan saja baris-baris itu.
Langkah 1: Cek Dulu Lewat URL Inspection
Laporan Page indexing tidak real-time. Laporan ini diperbarui tiap beberapa hari, dan tiap baris menunjukkan kondisi saat crawl terakhir yang diketahui. Jadi sebelum mengerjakan URL apa pun, tempel URL-nya di kolom URL Inspection (Inspeksi URL) di bagian atas Search Console.
Waktu saya cek halaman pendaftaran dari daftar di atas, hasilnya begini:
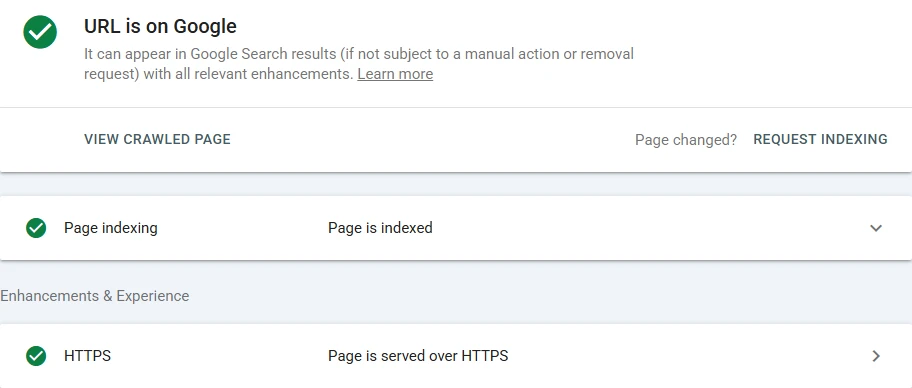
Halamannya ternyata sudah diindeks. Laporannya terakhir diperbarui 16 Oktober, lalu Google merayapi halaman itu lagi tanggal 17 Oktober dan mengindeksnya. Kalau saya langsung "memperbaiki" berdasarkan laporan saja, saya akan mengubah halaman yang sebenarnya sudah beres.
URL feed-nya memang benar-benar tidak diindeks:
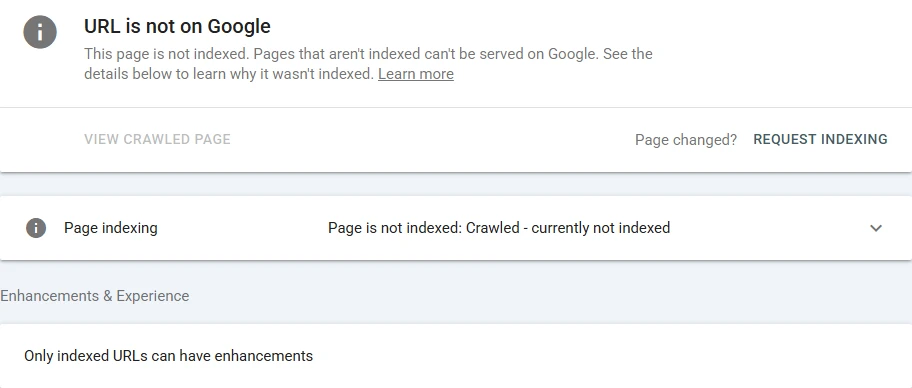
Untuk feed, hasil ini memang yang diharapkan. Tidak perlu diapa-apakan.
Langkah 2: Cari Penyebabnya dengan Cek Index
URL Inspection hanya memberi tahu statusnya. Alasan Google menganggap halaman itu tidak layak disimpan tidak ditampilkan. Untuk itu, lihat halamannya dari sisi crawler. Saya memakai cek index Google. Tool ini mengambil halaman dari server dengan user agent seperti crawler, lalu mengecek status code, redirect, robots.txt, noindex, canonical, dan jumlah teks di HTML mentahnya.
Ini hasil untuk halaman pendaftaran tadi:
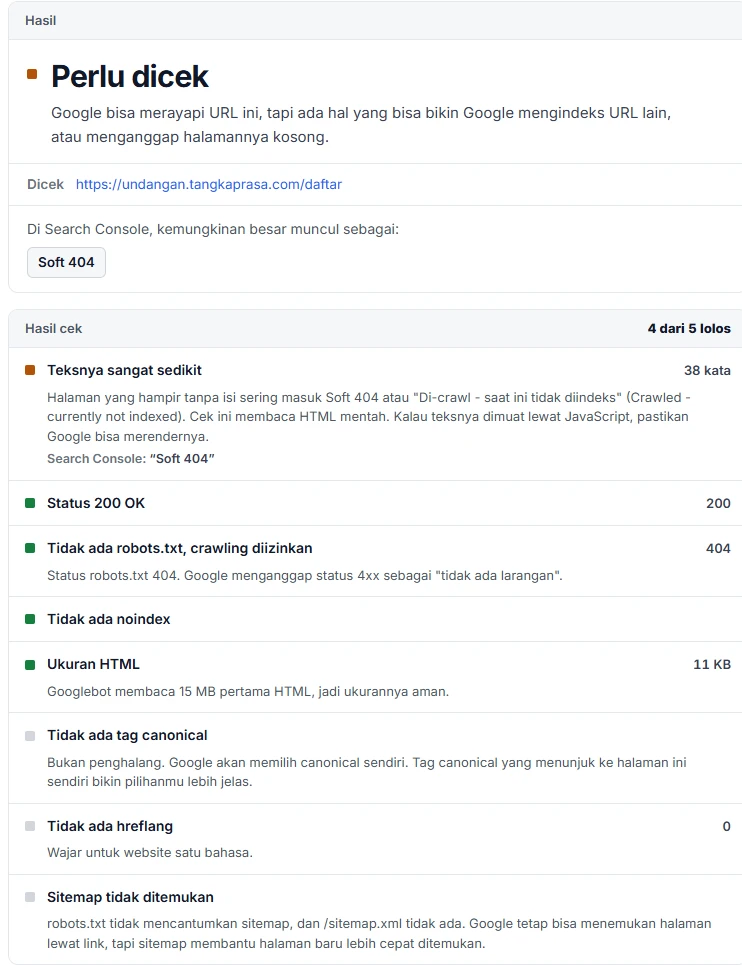
Semua cek teknis lolos: status 200, tidak ada noindex, tidak ada yang diblokir. Peringatan satu-satunya justru inti masalahnya. Halaman ini hanya berisi 38 kata. Form pendaftaran dengan satu judul dan dua tombol hampir tidak memberi Google apa pun untuk diindeks. Ini penyebab paling umum halaman yang sebenarnya penting masuk ke status ini.
Cara membaca hasilnya:
- Kalau ada cek teknis yang gagal (noindex, diblokir, redirect), itu masalah lain. Setelah Google merayapi ulang, URL-nya biasanya pindah ke status yang berbeda.
- Kalau semua cek teknis lolos, penyebabnya ada di isi halaman atau sinyal di sekitarnya. Itulah yang dibahas di bagian berikut.
Penyebab Crawled - Currently Not Indexed dan Cara Mengatasinya
URL-nya memang tidak perlu ada di Google
Feed, endpoint API, hasil pencarian internal, parameter filter dan urutan, halaman keranjang dan checkout, arsip tag yang isinya satu artikel, halaman attachment. URL seperti ini ikut dirayapi karena ada link yang mengarah ke sana, dan Google memang benar tidak mengindeksnya.
Solusinya: tidak perlu diperbaiki. Kalau daftarnya panjang dan kamu ingin lebih rapi, berhenti "mengiklankan" URL tersebut. Hapus link ke URL itu dari template, keluarkan dari sitemap, dan pasang noindex di jenis halaman yang memang tidak boleh muncul, misalnya hasil pencarian internal. Jangan blokir lewat robots.txt kalau URL-nya sudah terlanjur dirayapi dan kamu ingin URL itu hilang. URL yang diblokir tidak bisa dirayapi ulang, jadi Google tidak akan pernah melihat noindex-nya.
Isi halamannya terlalu tipis
Halaman yang isinya hanya judul, form, dan satu kalimat, atau halaman produk dengan deskripsi satu baris, memberi Google sedikit alasan untuk menyimpannya. Tambahkan yang benar-benar dibutuhkan pengunjung di halaman itu: produk atau jasanya apa, untuk siapa, harga atau cara menentukan harga, pertanyaan yang sering muncul, dan foto dengan alt text yang jelas. Targetnya bukan panjang, tapi berguna.
Halamannya mirip halaman lain
Halaman lokasi yang hanya beda nama kota, varian produk dengan teks yang sama persis, atau dua artikel yang menjawab pertanyaan yang sama. Google mengindeks satu dan melewati sisanya. Pilihannya: buat tiap halaman benar-benar berbeda, atau gabungkan jadi satu halaman yang lebih kuat lalu redirect yang lain ke sana.
Link internalnya lemah
Halaman yang hanya bisa ditemukan lewat sitemap, atau cuma di-link sekali dari footer, terlihat tidak penting. Tambahkan link ke halaman itu dari halaman lain yang relevan dan sudah diindeks, dengan anchor text yang menjelaskan isinya. Sering kali hanya perubahan ini yang dibutuhkan halaman bagus untuk akhirnya diindeks.
Website-nya masih baru
Google lebih pilih-pilih untuk website baru. Bisa jadi beranda dan beberapa halaman diindeks, sisanya ditahan sampai Google melihat sinyal lain. Terus terbitkan halaman yang jelas berguna, dapatkan beberapa link dari website yang relevan, dan antreannya biasanya berkurang dalam hitungan minggu sampai bulan.
Isi halamannya dimuat lewat JavaScript
Kalau teks utama baru muncul setelah JavaScript berjalan, lalu proses render gagal atau terlalu lama, Google bisa melihat halaman yang hampir kosong. Bandingkan jumlah kata di HTML mentah pada hasil cek dengan yang terlihat di browser. Kalau HTML mentahnya hampir kosong, tampilkan teks penting langsung dari server.
Urutan Memperbaiki Halaman yang Seharusnya Diindeks
- Pastikan lewat URL Inspection bahwa hari ini halamannya memang masih tidak diindeks.
- Cek halamannya di cek index Google dan pastikan semua cek teknis lolos.
- Perbaiki isinya: lebih berguna dan berbeda dari halaman lain yang mirip.
- Tambahkan link internal dari halaman lain yang relevan dan sudah diindeks.
- Pastikan URL akhirnya ada di sitemap. Cek sitemap bisa menunjukkan URL-nya ada atau tidak.
- Di URL Inspection, klik Request Indexing (Minta Pengindeksan) satu kali.
- Tunggu. Cek lagi 2 sampai 4 minggu kemudian, bukan tiap hari.
Request Indexing bukan solusi dengan sendirinya. Kalau halamannya tidak berubah, hasil crawl ulangnya juga sama.
Kenapa Validate Fix Sering Gagal?
Tombol Validate Fix (Validasi Perbaikan) meminta Google merayapi ulang semua URL di daftar dan memastikan masalahnya sudah hilang. Untuk status ini, validasi sering gagal. Alasannya masuk akal: kalau isi halamannya tidak berubah berarti, keputusan Google juga tidak berubah. Validasi juga ikut mengecek URL sampah yang memang kamu biarkan, dan URL itu akan tetap tidak diindeks.
Saran saya: jangan validasi status ini untuk seluruh daftar. Perbaiki halaman yang penting, minta pengindeksan untuk halaman itu saja, dan pantau satu per satu lewat URL Inspection. Angka di laporan akan menyesuaikan sendiri.
Kapan Jumlahnya Perlu Dikhawatirkan?
Lihat tren dan contohnya, bukan angkanya saja. Beberapa feed dan URL sistem itu normal di hampir semua website WordPress. Baru perlu khawatir kalau:
- Halaman penting (layanan, produk, artikel utama) ada di daftar.
- Angkanya terus naik tiap minggu, sementara jumlah halaman yang diindeks tidak bertambah.
- Artikel baru hampir selalu masuk ke sini, bukan sesekali.
Kalau begitu, masalahnya ada di kualitas atau link internal secara keseluruhan, dan memperbaiki halaman satu per satu tidak akan cukup.
Pertanyaan yang Sering Ditanyakan
Apa arti "Crawled - currently not indexed" di Google Search Console?
Google sudah merayapi halamannya, tapi memutuskan tidak mengindeksnya untuk sekarang. Tidak ada yang memblokir. Ini keputusan soal kualitas atau prioritas, dan halamannya bisa saja diindeks nanti.
Apakah status ini berbahaya untuk SEO?
Biasanya tidak. Status ini hanya jadi masalah kalau URL-nya memang ingin kamu tampilkan di Google. Untuk feed, endpoint API, halaman keranjang, dan sejenisnya, hasil ini sudah benar.
Berapa lama sampai halaman diindeks setelah diperbaiki?
Tidak ada waktu pasti. Setelah ada perbaikan nyata, crawl ulang dan keputusan baru biasanya butuh beberapa hari sampai beberapa minggu. Tanpa perubahan, halamannya bisa tetap di status ini terus.
Perlukah klik Request Indexing untuk halaman-halaman ini?
Perlu, tapi hanya setelah kamu mengubah sesuatu. Kalau halamannya sama, hasilnya juga sama, dan permintaan ini punya batas harian.
Apa bedanya dengan "Discovered - currently not indexed"?
"Crawled" berarti Google sudah membaca halaman dan memilih tidak mengindeksnya, jadi yang perlu dicek isi dan sinyalnya. "Discovered" berarti Google tahu URL-nya tapi belum merayapinya, jadi yang perlu dicek kapasitas server dan link internal.
Kenapa URL feed dan wp-json WordPress masuk status ini?
WordPress mencantumkan link ke feed dan REST API di kode setiap halaman, jadi Google menemukan dan mengambilnya. URL itu bukan halaman untuk pencari, jadi Google tidak mengindeksnya. Ini wajar dan aman dibiarkan.
Kesimpulan
Cek contohnya, abaikan URL sistem, pastikan status terbaru lewat URL Inspection, cari penyebabnya dengan cek index, lalu perbaiki isi dan link internal halaman yang memang penting. Masih belum beres dan halaman penting kamu terus masuk daftar ini? Audit website saya mengecek pengindeksan, konten, dan link internal sekaligus, atau hubungi saya dan saya bantu lihat.